Los programas de bug bounty no fallan porque los investigadores no puedan encontrar suficientes URLs. Fallan cuando el descubrimiento produce más candidatos de los que un equipo humano puede verificar, explicar y divulgar responsablemente. La ventaja no está en usar una wordlist más grande, sino en convertir observaciones autorizadas en una cola pequeña de hipótesis creíbles.
Qué está cambiando
Los programas modernos exponen una colección cambiante de aplicaciones web, APIs, backends móviles, activos cloud, sitios de documentación, entornos de staging e integraciones con proveedores. La entrega continua modifica rutas y certificados más rápido de lo que un inventario trimestral puede registrar. El desarrollo asistido por IA también aumenta el volumen de endpoints y configuraciones generadas, pero no establece propiedad ni permiso.
Para quien opera un programa, tener un programa de bounty no equivale a saber qué puede probarse de forma segura. Para el investigador, una lista extensa de subdominios tampoco demuestra que sean objetivos válidos. El alcance y la confianza deben acompañar a cada activo.
Empieza con un contrato de alcance
Antes de recolectar datos, registra la política, dominios incluidos, propiedades excluidas, límites de velocidad, técnicas prohibidas, reglas para cuentas de prueba, canal de divulgación y condiciones de puerto seguro. Conserva la URL de la política y la hora de consulta. Si es ambigua, pregunta por el canal oficial; no interpretes el silencio como permiso.
- Frontera: dominios, aplicaciones, APIs, paquetes móviles y entornos exactos.
- Identidad: si las pruebas son anónimas, autenticadas o limitadas a cuentas suministradas.
- Impacto: límites de prueba, datos sintéticos y condición inmediata de parada.
- Evidencia: requisitos del informe y manejo de artefactos sensibles.
Una solicitud rápida enviada al activo equivocado no es investigación eficiente: es un incidente de alcance evitable.
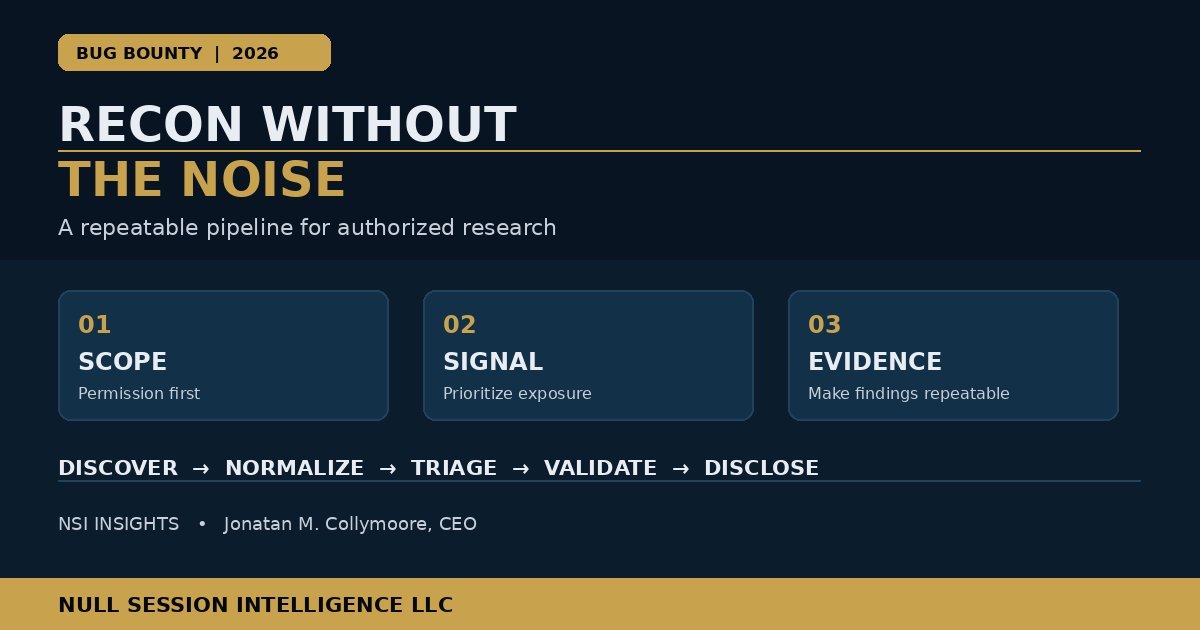
El pipeline: cinco etapas controladas
1. Descubrir con procedencia
Recolecta activos solo de fuentes aprobadas: listas del programa, DNS y certificados públicos dentro del alcance, documentación propia y flujos normales de la aplicación. Guarda fuente, hora, contexto de la herramienta y decisión de alcance. Un hostname sin procedencia es una pista, no un objetivo.
2. Normalizar y deduplicar
Canoniza hostnames, esquemas, puertos predeterminados, rutas y orden de parámetros. Conserva las redirecciones como relaciones; pueden revelar propiedad o transiciones de entorno. Agrupa endpoints en familias como /api/v1/accounts/{id}/exports en vez de tratar cada identificador como un descubrimiento nuevo.
clave = normalizar(host, esquema, puerto, plantilla)
si clave no está en inventario:
    inventario[clave] = {"fuentes": [], "estado": "sin revisar"}
inventario[clave]["fuentes"].append(observacion)
No se trata de ocultar duplicados. Conserva el número y las fuentes de las observaciones para distinguir confirmación independiente de recolección repetida.
3. Clasificar la señal
Prioriza con atributos transparentes: exposición pública, frontera de autenticación, flujo sensible, cambio reciente, confianza en la propiedad y riesgo operativo. Esto es triage, no severidad de vulnerabilidad. Una ruta pública de exportación merece más atención que un recurso estático, aunque ambos hayan aparecido una sola vez.
| Señal | Ejemplo de valor | Decisión |
|---|---|---|
| Exposición | API, carga, recuperación, webhook | Subir en la cola |
| Impacto | Cuenta, facturación, exportación | Usar identidades controladas |
| Confianza | Propietario desconocido o activo antiguo | Confirmar antes de profundizar |
| Cambio | Ruta o despliegue nuevo | Comparar con snapshot anterior |
4. Validar mínimamente
Usa la prueba menos intrusiva que responda la hipótesis. Confirma el comportamiento con registros sintéticos, evita enumerar identificadores reales y separa el descubrimiento de solo lectura de las solicitudes que cambian estado. Para autorización, usa dos cuentas controladas con roles diferentes y cambia una variable a la vez. Detente si la respuesta sugiere exposición de datos reales.
5. Preparar la evidencia
Un informe debe permitir que otro investigador reproduzca la observación sin recibir datos sensibles innecesarios. Registra activo en alcance, hora, contexto, comportamiento esperado y observado, evidencia saneada, razonamiento de impacto e hipótesis de remediación. Un hash del paquete local puede demostrar que no fue alterado durante la revisión.
Automatizar sin ampliar el alcance de forma autónoma
La automatización sirve para recolectar, normalizar, agrupar, comparar snapshots y gestionar la cola. Se vuelve peligrosa cuando adivina el alcance, aumenta la concurrencia porque el objetivo responde lento, fuerza identificadores o convierte una anomalía en hallazgo. Un worker seguro necesita allowlist, limitador, modo de solo lectura, auditoría y kill switch.
para observacion en fuentes_aprobadas:
    si no politica.permite(observacion.activo):
        continuar
    candidato = normalizar(observacion)
    cola.upsert(candidato, procedencia=observacion.fuente)

para candidato en cola.alta_confianza(limite=20):
    revision_humana(candidato)
    prueba_de_bajo_impacto(candidato)
La IA puede resumir respuestas repetidas, sugerir familias de rutas, comparar inventarios y señalar contradicciones entre política y tráfico observado. El investigador humano decide si la prueba está permitida, si el comportamiento es explotable y si la evidencia justifica divulgarlo.
Métricas que premian la calidad
No optimices por cantidad de subdominios. Mide tiempo de descubrimiento a triage, tasa de duplicados, porcentaje de candidatos con propietario y fuente, rendimiento de validación, falsos positivos, tiempo mediano para completar evidencia y excepciones de alcance. Para el operador del programa, mide también la velocidad con que los activos nuevos entran en la política y reciben una respuesta clara.
Runbook semanal práctico
- Lunes: captura política, alcance y activos conocidos.
- Martes: recolecta observaciones aprobadas y conserva la procedencia.
- Miércoles: normaliza, deduplica y clasifica familias de rutas.
- Jueves: valida las hipótesis de mayor confianza e impacto con datos sintéticos.
- Viernes: reproduce, redacta y envía solo hallazgos respaldados.
Qué sigue
El recon de bug bounty será más automatizado y más concurrido. Ganarán los equipos capaces de explicar por qué cada candidato estaba en alcance, cómo se priorizó y qué evidencia respalda la conclusión. La IA comprimirá el trabajo clerical; la gobernanza y el criterio serán los diferenciadores.
Preguntas frecuentes
¿Qué hace repetible un pipeline de recon?
Un alcance definido, fuentes documentadas, normalización determinista, deduplicación, triage transparente, validación acotada y evidencia reproducible.
¿Todo subdominio descubierto está en alcance?
No. El descubrimiento crea un candidato. La política, la propiedad confirmada y el puerto seguro determinan si las pruebas están permitidas.
¿Cómo ayuda la IA de forma segura?
Puede normalizar datos, agrupar rutas, comparar snapshots y resumir observaciones. No debe ampliar alcance, enviar solicitudes destructivas ni declarar una vulnerabilidad sin validación humana.
¿Qué evidencia debe incluir un informe?
Activo en alcance, hora, contexto, comportamiento esperado y observado, prueba mínima saneada, impacto e hipótesis clara de remediación.
¿Necesitas un pipeline de investigación autorizado?
NSI ayuda a convertir superficies cambiantes en decisiones de seguridad acotadas y respaldadas por evidencia.
Definir el alcance